工业生产优化
热处理炉能耗与排产优化系统
面向热处理生产现场的炉次能耗分析、模型校准与排产决策系统
接入炉子真实采集数据,自动识别炉次并核算能耗与电费,再结合热炉模型、工艺路线和分时电价评估生产成本、优化开炉时间。
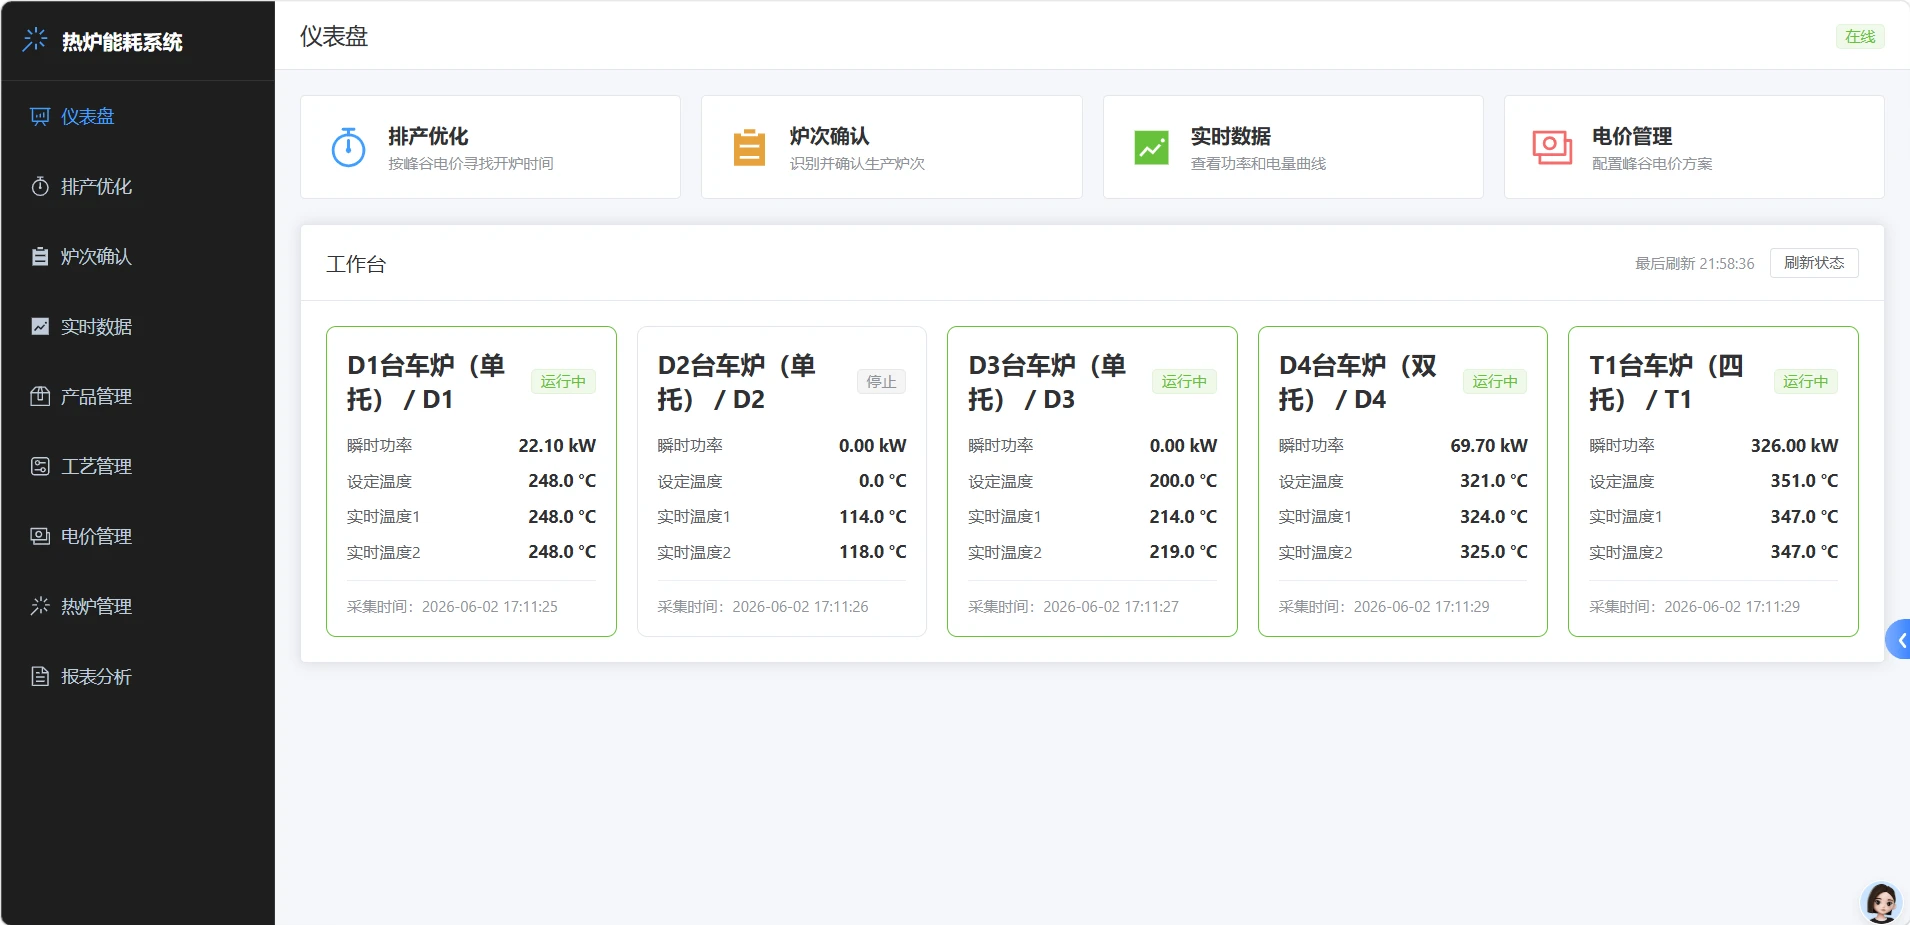
- 功率、电量、温度与分时电费实时看板
- 基于运行状态和采集数据自动识别炉次
- 人工确认炉次并沉淀真实生产记录
- 热炉模型、炉号绑定与能耗参数维护
从能耗监控进入热处理生产决策
热处理现场的功率、电量和温度记录来自不同炉号与采集点位。只展示实时曲线无法回答一次生产用了多少电、执行了什么工艺、理论消耗是否合理,以及下一炉安排在什么时间成本更低。
系统把现场采集数据与热炉、产品、工艺、电价和炉次记录结合起来,形成从真实生产记录到能耗核算、模型评估和排产优化的本地业务闭环。
把连续采集数据整理为可确认的炉次记录
系统读取 MySQL 采集库中的运行状态、瞬时功率、累计电量和温度点位,将连续运行区间识别为候选炉次;短暂停机可按配置合并,过短或能耗过低的片段会被过滤。
候选炉次经人工确认后写入本地业务库。炉次详情使用真实采集数据展示功率、温度、分时电量和分时电费,模型估算结果不会替代现场实测口径。
真实电费与模型费用采用两套清晰口径
真实分时电量直接读取现场已经拆分好的尖峰、高峰、平段、谷段和深谷累计点位差值,再按炉次发生年月匹配对应电价方案。跨月生产按采集聚合桶所在年月分别计算。
模型费用根据热炉参数、产品工艺时间线和电价时段估算。实测数据用于还原现场实际消耗,模型计算用于理论评估和排产决策,两类结果可以比较但不会混为同一数据口径。
用历史炉次辅助校准热炉能耗模型
热炉模型维护炉号绑定、最大温度、升温速率、额定功率和分段能耗参数。系统可以从已确认炉次中读取真实功率、电量与温度,识别升温和保温片段,生成分温度段的参数建议。
校准结果同时展示样本数、可信度和误差改善,只有用户主动确认后才写回模型参数,避免异常采集数据自动改变生产模型。
把分时电价转化为可比较的开炉方案
排产页面组合产品、工艺、热炉和电价方案,在不改变升温、保温等工艺阶段的前提下,对不同开炉时间进行成本计算。
生产人员可以比较候选方案的时间线、理论能耗和分时电费,选择满足工艺要求且成本更合适的开炉时间。系统当前聚焦单炉能耗与时间优化,不将其描述为完整的 MES 排产系统。
本地部署方式与当前边界
前端使用 Vue 3、Element Plus 和 ECharts,后端使用 FastAPI 与 SQLAlchemy。SQLite 保存热炉、产品、工艺、电价、炉次和计算记录,MySQL 保存现场点位及历史采集数据。
项目面向 Windows 本地及工厂内网环境,支持前后端启动、桌面环境部署、打包发布和授权文件管理。在线体验依赖本地服务与采集环境;项目详情暂不展示未经确认的客户名称、节省比例或生产成果。